Posty

Wyświetlam posty z etykietą whisper

[K] Chapters Creator 3.4

Obraz
Unowocześniałem niedawno Kastera , czyli mój osobisty program do zarządzania podcastem. Podczas prac związanych z możliwością otwarcia pliku mp3 danego odcinka bezpośrednio w Chapters Creatorze , postanowiłem dokończyć zmiany w tym ostatnim programie. Jakiś czas temu zacząłem rozwijać w nim edytor transkrypcji, ale utknął on w martwym punkcie. Kaster także dorobił się możliwości wyświetlania i edycji transkrypcji, podobnie na transkrypcjach bazuje SubtitleJoiner , więc przyszła pora, by logikę związaną z tym przenieść także do Chapters Creatora . Nie tylko edytor Skoro jednak Chapters Creator ma umożliwić edycję transkrypcji w postaci plików srt oraz opracowywanie rozdziałów na tej podstawie, dlaczego nie miałby móc "zintegrować się" z programem do tworzenia transkrypcji? W końcu Const-me Whisper oferuje możliwość pracy z linii poleceń, a stąd już tylko kroczek do umożliwienia Chapters Creatorowi wywołania Const-me Whispera i stworzenia transkrypcji! Ta właśnie my...

[K] SubtitleJoiner

Obraz
Omawiany dzisiaj program to bardzo proste narzędzie, które ma dość nieoczywisty cel. Otóż jeśli generujemy sobie transkrypcje, np. za pomocą programu Whisper , w efekcie najczęściej dostajemy plik napisów w formacie srt . To połączenie rozpoznanego tekstu oraz znaczników czasowych, dzięki czemu taki plik można wykorzystać, wrzucając go bezpośrednio do serwisu YouTube lub osadzając w pliku wideo ( DaVinci Resolve posiada na przykład taką możliwość). Czasem jednak napisy są bardzo rozdrobnione, a chciałoby się na ekranie zmieścić trochę większą ich część. Na razie Whisper , zwłaszcza w tej przeniesionej do C++ szybkiej wersji, nie wspiera czegoś takiego, jak grupowanie poszczególnych sentencji np. pod względem czasowym. A że "w narodzie" była taka potrzeba, napisałem SubtitleJoinera , który choć pobieżnie rozwiązuje problem. Jak używać? Program jest prosty do bólu i w związku z tym ma swoje ograniczenia, ale koniec końców to do użytkownika należy decyzja, czy te ogranicze...

Whisperowa transkrypcja w C++

Obraz
Możliwość transkrypcji audio rozpala ostatnio wyobraźnię wielu osób, a jakość rezultatów zaprezentowanego już pół roku temu Whispera wzbudza co najmniej podziw. Niestety, zarówno "oryginalny" Whisper , jak i jego okienkowa wariacja sprawiają nieco problemów. A to trzeba zainstalować Pythona , język programowania, a to pościągać sterowniki, a to - o zgrozo! - napisać jakiś skrypt. Na dodatek wydajność przy przetwarzaniu samym procesorem komputera jest dla lepszych modeli językowych ( large i medium ) zazwyczaj mało satysfakcjonująca, wymuszając zastosowanie wydajnej karty graficznej z dużą ilością pamięci (no i równie dużą ceną). Dzisiaj natknąłem się na wpis kolegi Rafała Bielawskiego, który wyszukał nowe cudo: Const-me Whisper , czyli port do Whispera , napisany w C++. Ma to swoje wymierne korzyści: po pierwsze, zwiększoną wydajność, po drugie, łatwość użycia. Ładujemy się zatem na stronę projektu i z sekcji Releases pobieramy odpowiednie archiwum: Jeśli ktoś lubi ...

Whisper - poprawiam skrypt

Obraz
Korzystam z programu Whisper już półtora miesiąca i od momentu zastosowania RTX3060 bardzo sobie to chwalę. Jako programista i zwolennik pisania skryptów w Pythonie , wolę właśnie surową instalację Whispera zamiast okienkowej nakładki, Speech Translate . Jednak sprawiedliwie trzeba przyznać, że Speech Translate ma w pewnej istotnej kwestii przewagę - potrafi tworzyć pliki srt z napisami. Na szczęście użytkownicy Whispera nie stoją na straconej pozycji, do czego wrócę za chwilę, bo najpierw na rozwiązanie czeka inny problem. Pasek postępu Ze względu na to, że transkrypcja swoje trwa, bardzo brakowało mi informacji, ile czasu zajmie przetwarzanie danego pliku dźwiękowego. Domyślny, najprostszy skrypt, który podawałem w pierwszym poście , wyglądał dla przypomnienia tak: import whisper; model = whisper.load_model("base") result = model.transcribe("f:\\podcast_010049.mp3") print(result["text"]) Skrypt ten, przerobiony na model large (zamiast bas...

[K] Speech Translate - Whisper w okienku

Obraz
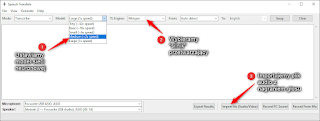
UWAGA NA WSTĘPIE: Warto zajrzeć do nowszego posta na temat Whispera w bardziej "strawnej" wersji! O, tego właśnie szukałem! Wprawdzie osobiście używam programu Whisper z poziomu języka Python , ale wiem, że nie jest to na nerwy każdego. Stąd bardzo ucieszyłem się, że trafiłem na program Speech Translate , który potrafi wykonać transkrypcję za pomocą Whispera i da się go zainstalować i uruchomić "po ludzku" w systemie Windows 10/11 . Tu szybkie wyjaśnienie dla osób, które nie czytały wpisu o Whisperze - Whisper dokonuje transkrypcji plików dźwiękowych z wykorzystaniem sieci neuronowych (a konkretnie jednego z pięciu dostępnych modeli takiej sieci: tiny , base , small , medium i large ). Każdy kolejny model jest bardziej złożony i skorzystanie z niego wiąże się z wydłużeniem procesu transkrypcji, ale jednocześnie dostarcza on dokładniejszego, lepszego rezultatu. Proces transkrypcji wymaga dużej mocy obliczeniowej, tym większej, im bardziej skomplikowanego mo...

Whisper, czyli robimy z głosu tekst

UWAGA NA WSTĘPIE: Warto zajrzeć do nowszego posta na temat Whispera w bardziej "strawnej" wersji! Pisałem w sierpniu 2021 o możliwościach komputera w rozpoznawaniu mowy. Wówczas wprawdzie bardziej chodziło mi o przyspieszenie pracy nad skryptem, żeby nie tracić czasu na klepanie w klawiaturę, jednak okazało się, że piszę dużo szybciej, niż jestem w stanie dyktować komputerowi. Ale, tak czy owak, warto przygotować transkrypcję audycji dla osób, które nie są w stanie jej wysłuchać. Wprawdzie w przypadku mojego podcastu wydaje się to trochę abstrakcyjne, bo jak przełożyć na tekst test mikrofonu, ale przecież nie ja jeden robię podcasty. Kiedy więc kolega Piotr Bartkowski zapytał mnie, czy słyszałem o darmowym programie Whisper , czujnie postawiłem uszy i stanąłem słupka. Oho! Schooody Początki zabawy z Whisperem nie napawają jednak optymizmem. Po pierwsze, warto mieć zainstalowany język Python w komputerze, bo wygodnie korzysta się z Whispera za pośrednictwem tego wł...